مقالههوش مصنوعی سازمانی
توهم (Hallucination) هوش مصنوعی: چرا مدل با اعتمادبهنفس اشتباه میگوید و ۸ راه کاهش آن
توهم یعنی تولید پاسخ روان و قانعکننده اما نادرست یا ساختگی. علت آن ماهیت مدل زبانی است که متن محتمل تولید میکند، نه بررسی واقعیت؛ بهعلاوه داده ناقص، نبود منبع، پرسش مبهم و سازوکار آموزشی که حدس را پاداش میدهد. هشت راه کاهش: RAG، ارجاع به منبع، اجازه «نمیدانم»، پرسش دقیق، دمای پایین، قالب خروجی محدود، تأیید انسانی و ارزیابی مداوم. هیچ روشی توهم را به صفر نمیرساند.
خلاصه در چند نکته
- توهم ویژگی ذاتی مدلهای زبانی است و به صفر نمیرسد.
- NIST آن را Confabulation و OWASP آن را ریسک اطلاعات نادرست مینامد.
- پاسخ از روی سند (RAG) مؤثرترین راه کاهش است.
- ارجاع به منبع بررسی پاسخ را در چند ثانیه ممکن میکند.
- سامانه باید در نبود سند مرتبط بگوید پاسخی ندارد.
- در کارهای حساس، خروجی پیشنویس است و انسان تأیید میکند.
- کیفیت و بهروز بودن اسناد مستقیماً بر خطا اثر دارد.
فهرست مطالب
هر کسی که مدتی با ChatGPT یا ابزارهای مشابه کار کرده باشد، احتمالاً با این صحنه روبهرو شده است: از مدل درباره یک قانون، یک آمار یا یک منبع میپرسید و پاسخی روان، مطمئن و با جزئیات دقیق دریافت میکنید؛ اما وقتی بررسی میکنید، میبینید آن ماده قانونی وجود ندارد، آن عدد ساختگی است یا آن کتاب هرگز نوشته نشده است. به این پدیده توهم هوش مصنوعی (Hallucination) میگویند.
در استفاده شخصی، توهم ممکن است فقط آزاردهنده باشد. اما در سازمان، وقتی پاسخ هوش مصنوعی مبنای یک نامه رسمی، تصمیم مالی یا پاسخ به مشتری قرار میگیرد، پیامد آن میتواند جدی باشد. این مقاله توضیح میدهد چرا مدلهای زبانی با اعتمادبهنفس اشتباه میگویند و هشت راهکار عملی برای کاهش این خطا ارائه میدهد. یک نکته را از همین ابتدا روشن کنیم: هیچ روشی توهم را به صفر نمیرساند؛ هدف، کاهش احتمال آن و آسان کردن تشخیص آن است.
توهم هوش مصنوعی یعنی چه؟
توهم یعنی تولید محتوایی که از نظر زبانی درست و قانعکننده به نظر میرسد، اما از نظر واقعیت نادرست، ساختگی یا بیپشتوانه است. چارچوب NIST برای ریسکهای هوش مصنوعی مولد از اصطلاح «Confabulation» (سرهمبافی) برای این پدیده استفاده میکند و فهرست OWASP برای برنامههای مدل زبانی، «اطلاعات نادرست» را یکی از ده ریسک اصلی میشمارد.
شکلهای رایج توهم:
| نوع | نمونه |
|---|---|
| واقعیت ساختگی | نسبت دادن یک بخشنامه به سازمانی که چنین بخشنامهای نداده |
| عدد ساختگی | آمار دقیق اما بیمنبع |
| منبع ساختگی | ارجاع به مقاله یا کتابی که وجود ندارد |
| تحریف سند | خلاصهای از نامه که نکتهای را اضافه یا برعکس میکند |
| ترکیب نادرست | چسباندن اطلاعات دو سند متفاوت به یکدیگر |
| پاسخ به جای «نمیدانم» | پاسخ دادن به پرسشی که اطلاعاتش در دسترس مدل نیست |
چرا مدل با اعتمادبهنفس اشتباه میگوید؟
برای فهم توهم باید به یاد داشته باشیم مدل زبانی چگونه کار میکند. مدل زبانی در اصل پیشبینی میکند کدام کلمه یا توکن به احتمال زیاد پس از متن قبلی میآید. هدف آن تولید متن محتمل و روان است، نه بررسی درستی واقعیت. مبانی این سازوکار را در مقاله مدل زبانی بزرگ چیست توضیح دادهایم.
۱. داده آموزشی ناقص یا قدیمی
مدل فقط آنچه را در داده آموزشی دیده «میداند». اگر اطلاعاتی در آن داده نبوده، قدیمی شده یا بهندرت تکرار شده، مدل جای خالی را با الگوهای محتمل پر میکند. برای مثال، مدلی که درباره آییننامه داخلی سازمان شما چیزی ندیده، ممکن است آییننامهای «محتمل» بسازد.
۲. نبود منبع در لحظه پاسخ
وقتی از مدل بدون ارائه سند میپرسیم، مدل پاسخ را از حافظه آماری خود میسازد. هیچ متن مرجعی وجود ندارد که پاسخ با آن سنجیده شود.
۳. پرسش مبهم
پرسشهایی مانند «قانون جدید مرخصی چه میگوید؟» بدون مشخص کردن کدام قانون، کدام سال یا کدام سازمان، مدل را وادار به حدس میکنند.
۴. سازوکار آموزش و ارزیابی
پژوهشی که OpenAI در سال ۲۰۲۵ منتشر کرد استدلال میکند که روشهای رایج آموزش و ارزیابی مدلها، «حدس زدن» را بیش از «اعتراف به ندانستن» پاداش میدهند؛ مانند آزمونی چهارگزینهای که پاسخ ندادن نمره منفی ندارد اما حدس زدن شانس نمره دارد. نتیجه، مدلی است که تمایل دارد بهجای «نمیدانم»، پاسخی مطمئن بدهد.
۵. متن طولانی و پیچیده
وقتی سند بسیار طولانی است یا چند سند متناقض به مدل داده میشود، احتمال اشتباه در ترکیب اطلاعات بیشتر میشود.
۶. ضعف در زبان یا حوزه تخصصی
در زبانهایی مانند فارسی که سهم کمتری از داده آموزشی دارند، و در حوزههای تخصصی مانند حقوق یا مالیات ایران، احتمال توهم بالاتر است.
هشت راه کاهش توهم در سازمان
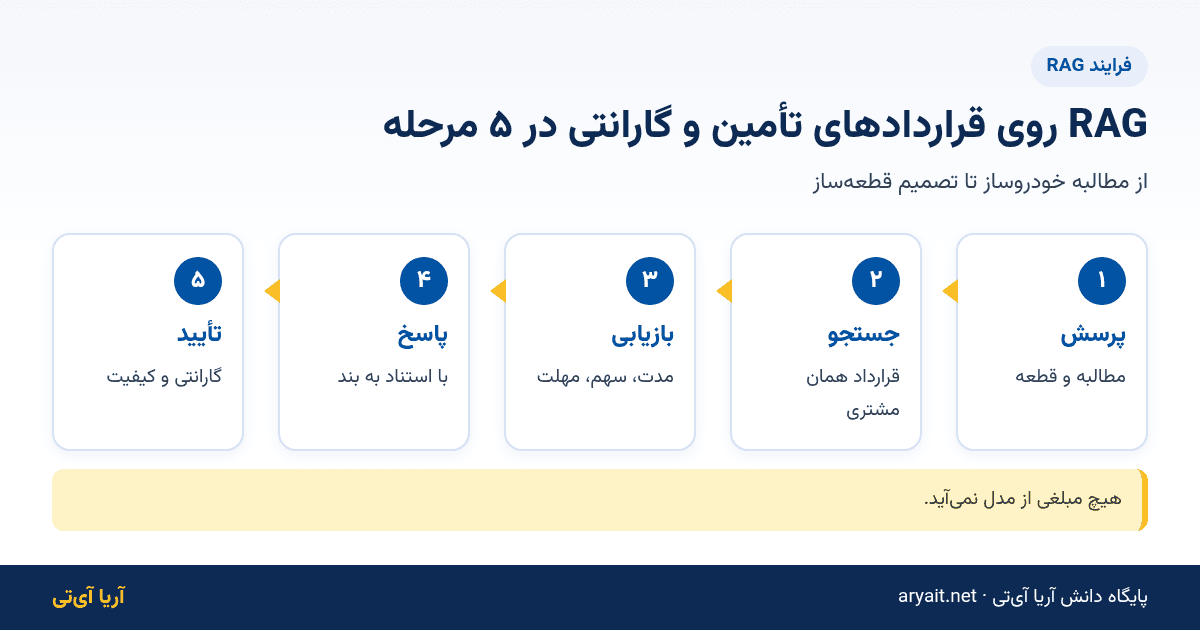
راه ۱: پاسخ از روی سند (RAG)
مؤثرترین راهکار این است که مدل بهجای پاسخ از حافظه، پاسخ را از اسناد واقعی سازمان بسازد. در روش تولید افزوده با بازیابی (RAG)، ابتدا اسناد مرتبط با پرسش جستجو و یافته میشوند و سپس متن آنها همراه پرسش به مدل داده میشود. این روش احتمال توهم را بهطور محسوسی کاهش میدهد، اما حذف نمیکند؛ مدل همچنان ممکن است سند را بد بخواند یا نکتهای اضافه کند.
راه ۲: ارجاع به منبع
هر پاسخ باید نشان دهد از کدام سند، نامه یا بند آمده است. ارجاع به منبع دو فایده دارد: کاربر میتواند پاسخ را در چند ثانیه بررسی کند، و طراحی سامانه مدل را تشویق میکند فقط به متن موجود تکیه کند.
راه ۳: اجازه «نمیدانم» گفتن
دستورهای سامانه باید صریحاً بگویند اگر پاسخ در اسناد یافتهشده نیست، مدل اعلام کند که اطلاعات کافی وجود ندارد. سامانه هم میتواند وقتی هیچ سند مرتبطی پیدا نشد، اصلاً پاسخی تولید نکند. پاسخ ندادن بسیار بهتر از پاسخ ساختگی است.
راه ۴: پرسش دقیق
آموزش کارکنان برای نوشتن پرسش روشن، با ذکر سند، دوره زمانی و قالب پاسخ، تأثیر زیادی دارد. نکات نوشتن دستور خوب را در راهنمای پرامپتنویسی برای کارکنان اداری آوردهایم.
راه ۵: تنظیمات تولید محافظهکارانه
پارامترهایی مانند «دما» (Temperature) میزان تصادفی بودن خروجی را تعیین میکنند. برای کارهای مبتنی بر واقعیت مانند پاسخ از آییننامه یا استخراج اطلاعات، دمای پایینتر خروجی قابل پیشبینیتری میدهد.
راه ۶: محدود کردن قالب خروجی
وقتی خروجی ساختار مشخصی دارد (مثلاً فیلدهای «شماره قرارداد»، «تاریخ»، «مبلغ»)، فضای سرهمبافی کمتر میشود و بررسی خودکار هم آسانتر است. مثلاً میتوان بررسی کرد که شماره استخراجشده واقعاً در متن سند وجود دارد.
راه ۷: تأیید انسانی در کارهای حساس
در هر کاری که پیامد دارد، مانند ارسال نامه، پاسخ به مشتری یا تصمیم مالی، خروجی هوش مصنوعی باید پیشنویس باشد و انسان آن را تأیید کند. مدل پیشنهاد میدهد، انسان تصمیم میگیرد.
راه ۸: ارزیابی و پایش مداوم
یک مجموعه پرسش آزمون با پاسخ درست بسازید و سامانه را بهطور منظم با آن بسنجید. بازخورد کاربران («این پاسخ نادرست بود») را جمعآوری کنید و موارد تکراری را بررسی کنید. کیفیت خود اسناد هم مهم است؛ اسناد قدیمی، متناقض یا مبهم منبع خطا هستند. نکات نوشتن اسناد مناسب برای هوش مصنوعی را در مقاله نگارش پایگاه دانش آماده برای هوش مصنوعی ببینید.
یک مثال از کار اداری
فرض کنید کارشناسی از دستیار میپرسد: «سقف مأموریت روزانه کارکنان در آییننامه ما چقدر است؟» در حالت بدون منبع، مدل ممکن است عددی محتمل اما نادرست بگوید. در حالت درست طراحیشده، سامانه ابتدا آخرین نسخه آییننامه مأموریت را جستجو میکند، بند مربوط را پیدا میکند، پاسخ را از همان بند میسازد و پیوند به سند را نشان میدهد. اگر آییننامه در دسترس کاربر نباشد یا بند مرتبطی پیدا نشود، سامانه صادقانه اعلام میکند که پاسخی در اسناد مجاز پیدا نکرده است. تفاوت این دو حالت، تفاوت یک ابزار سرگرمکننده با یک ابزار قابل اعتماد کاری است.
جمعبندی راهکارها
| راهکار | اثر اصلی | هزینه اجرا |
|---|---|---|
| RAG | پاسخ از سند به جای حافظه | متوسط تا بالا |
| ارجاع به منبع | امکان بررسی سریع | متوسط |
| اجازه «نمیدانم» | حذف پاسخ ساختگی در نبود منبع | پایین |
| پرسش دقیق | کاهش حدس | پایین (آموزش) |
| دمای پایین | خروجی پایدارتر | پایین |
| قالب محدود | فضای کمتر برای سرهمبافی | پایین |
| تأیید انسانی | جلوگیری از پیامد خطا | متوسط (زمان کارکنان) |
| ارزیابی مداوم | کشف و رفع الگوهای خطا | متوسط |
چکلیست کاهش توهم در پروژه هوش مصنوعی
- [ ] پاسخها بر پایه اسناد سازمان ساخته میشوند، نه حافظه عمومی مدل.
- [ ] هر پاسخ ارجاع به منبع دارد و کاربر میتواند آن را باز کند.
- [ ] در نبود سند مرتبط، سامانه اعلام میکند پاسخی ندارد.
- [ ] کارکنان برای نوشتن پرسش دقیق آموزش دیدهاند.
- [ ] خروجیهای حساس فقط پس از تأیید انسانی استفاده میشوند.
- [ ] مجموعه آزمون و سازوکار بازخورد کاربران وجود دارد.
- [ ] اسناد قدیمی و متناقض شناسایی و پاکسازی شدهاند.
اشتباههای رایج
- باور به «صفر توهم»: هر فروشندهای که چنین وعدهای بدهد، واقعبینانه صحبت نمیکند.
- اعتماد به لحن مطمئن: روانی متن نشانه درستی آن نیست.
- حذف بازبینی برای سرعت: صرفهجویی چند دقیقهای ممکن است به یک نامه رسمی نادرست ختم شود.
- نادیده گرفتن کیفیت اسناد: RAG روی اسناد متناقض، پاسخ متناقض میدهد.
برای یک دستیار داخلی کارکنان که با همین اصول طراحی شده، مقاله چتبات داخلی کارکنان را ببینید.
رویکرد آریا آیتی
دستیار هوش مصنوعی سازمانی آریا آیتی پاسخ را فقط از نامهها، جلسات، کارها و اسناد مجاز سازمان میسازد و برای هر پاسخ ارجاع به منبع نشان میدهد تا کاربر بتواند آن را بررسی کند. نقشها و سطح دسترسی رعایت میشود و در همه قابلیتها مدل پیشنهاد میدهد و انسان تأیید میکند. این طراحی احتمال توهم را کاهش میدهد و تشخیص آن را آسان میکند، اما مانند هر سامانه هوش مصنوعی دیگری، بازبینی انسانی در کارهای حساس همچنان لازم است.
جمعبندی
توهم ویژگی ذاتی مدلهای زبانی است: آنها برای تولید متن محتمل ساخته شدهاند، نه برای بررسی واقعیت. علل اصلی، داده ناقص، نبود منبع، پرسش مبهم و سازوکاری است که حدس را بیش از «نمیدانم» پاداش میدهد. ترکیب پاسخ از روی سند، ارجاع به منبع، اجازه «نمیدانم»، پرسش دقیق، تنظیمات محافظهکارانه، قالب محدود، تأیید انسانی و ارزیابی مداوم، خطر را بهطور جدی کاهش میدهد؛ بدون اینکه وعده صفر شدن آن را بدهیم.
مشاوره رایگان: برای بررسی اینکه دستیار سازمانی با ارجاع به منبع چگونه در سازمان شما کار میکند، با کارشناسان آریا آیتی گفتوگو کنید یا درخواست پایلوت دستیار (پلن سازمانی) را ثبت کنید.
پرسشهای متداول
چرا ChatGPT گاهی جواب غلط با اطمینان میدهد؟
+
چون مدل زبانی برای تولید متن محتمل و روان ساخته شده، نه بررسی واقعیت. وقتی اطلاعات کافی ندارد، جای خالی را با الگوهای محتمل پر میکند و سازوکار آموزش هم معمولاً حدس زدن را بیش از گفتن «نمیدانم» پاداش میدهد.
آیا RAG توهم را کاملاً از بین میبرد؟
+
نه. RAG با دادن متن سند به مدل، احتمال توهم را بهطور محسوسی کم میکند، اما مدل ممکن است سند را بد بخواند یا نکتهای بیفزاید. ارجاع به منبع و بازبینی انسانی همچنان لازم است.
چطور توهم را در پاسخ تشخیص دهیم؟
+
منبع پاسخ را بررسی کنید؛ اگر پاسخ ارجاع ندارد یا ارجاع آن نکته گفتهشده را تأیید نمیکند، به آن اعتماد نکنید. به آمارهای دقیق، شماره مواد قانونی و نام منابع بیارجاع حساس باشید.
آیا ابزاری با صفر درصد توهم وجود دارد؟
+
خیر. هیچ مدل زبانی فعلی توهم صفر ندارد. هدف واقعبینانه کاهش احتمال خطا و آسان کردن تشخیص آن با ارجاع به منبع و تأیید انسانی است.