تعریف اصطلاحهوش مصنوعی سازمانی
مدل زبانی بزرگ (LLM) چیست؟ توضیح ساده برای مدیران و کارکنان غیرفنی
مدل زبانی بزرگ (LLM) مدل هوش مصنوعی آموزشدیده روی حجم عظیمی از متن است که با پیشبینی ادامه متن، پاسخ تولید میکند، خلاصه میکند یا متن را دستهبندی میکند. مدل متن را به توکن تقسیم میکند، در مراحل پیشآموزش، تنظیم با دستور و همراستاسازی آموزش میبیند و هنگام پاسخ (استنتاج) چیز تازهای یاد نمیگیرد. محدودیتهای اصلی: توهم، تاریخ قطع دانش، ناآگاهی از داده سازمان، حساسیت به پرسش و سوگیری. در سازمان، پاسخ باید با بازیابی از اسناد مجاز و ارجاع به منبع ساخته شود.
خلاصه در چند نکته
- LLM با پیشبینی ادامه متن، زبان را تولید و درک میکند.
- مدل متن را به توکن تقسیم میکند؛ فارسی معمولاً توکن بیشتری مصرف میکند.
- آموزش شامل پیشآموزش، تنظیم با دستور و همراستاسازی با بازخورد انسانی است.
- در استنتاج، مدل از گفتوگوی شما یاد نمیگیرد.
- توهم، تاریخ قطع دانش و ناآگاهی از داده سازمان محدودیتهای اصلیاند.
- در سازمان، پاسخ باید به اسناد مجاز و با ارجاع به منبع متکی باشد.
فهرست مطالب
وقتی کسی از ChatGPT، Gemini، Claude یا مدلهای ایرانی و متنباز حرف میزند، در واقع درباره یک فناوری مشترک صحبت میکند: مدل زبانی بزرگ یا LLM. این فناوری پایه بیشتر ابزارهای هوش مصنوعی امروز است؛ از چتباتها و دستیارهای نوشتن گرفته تا ایجنتها و جستجوی معنایی. با این حال، بسیاری از مدیران و کارکنان هنوز تصویر روشنی ندارند که این مدلها دقیقاً چه هستند، چگونه کار میکنند و چرا گاهی با اعتمادبهنفس کامل اشتباه میگویند.
این مقاله صفحه مرجع ما درباره مدلهای زبانی است و بدون فرمول ریاضی، مفاهیم اصلی را برای افراد غیرفنی توضیح میدهد: مدل زبانی چیست، چگونه آموزش میبیند، هنگام پاسخدادن چه میکند، چه محدودیتهایی دارد و چرا در سازمان، پاسخ آن باید به داده خود سازمان متکی باشد.
مدل زبانی بزرگ چیست؟ تعریف ساده
مدل زبانی بزرگ (Large Language Model) نوعی مدل هوش مصنوعی است که با حجم بسیار زیادی متن آموزش دیده تا الگوهای زبان را بیاموزد و بتواند متن تولید کند، به پرسش پاسخ دهد، خلاصه کند، ترجمه کند یا متن را دستهبندی کند. AWS در تعریف خود، LLM را مدل یادگیری عمیق بسیار بزرگی معرفی میکند که روی دادههای عظیم پیشآموزش دیده و بر پایه معماری «ترنسفورمر» ساخته شده است.
سادهترین توصیف کار مدل زبانی این است: پیشبینی ادامه متن. مدل با دیدن یک متن، محتملترین واحد بعدی را پیشبینی میکند، آن را اضافه میکند و دوباره پیشبینی میکند. وقتی این کار با مدلی بسیار بزرگ و آموزشدیده روی متنهای متنوع انجام شود، نتیجه پاسخی روان و معنادار است.
چرا «بزرگ»؟
«بزرگ» به دو چیز اشاره دارد: حجم داده آموزشی (معمولاً صدها میلیارد تا تریلیونها واحد متن) و تعداد پارامترها، یعنی اعدادی که مدل در طول آموزش تنظیم میکند. مدلهای امروزی از چند میلیارد تا صدها میلیارد پارامتر دارند. مدلهای کوچکتری هم با عنوان مدل زبانی کوچک (SLM) وجود دارند که برای کارهای محدودتر بهینه شدهاند.
توکن: واحد کار مدل
مدل زبانی متن را به شکل واژه نمیبیند، بلکه آن را به توکن تقسیم میکند. توکن ممکن است یک واژه کامل، بخشی از یک واژه یا یک نشانه نگارشی باشد. در زبان فارسی، به دلیل سهم کمتر فارسی در داده آموزشی بسیاری از مدلها، یک واژه اغلب به چند توکن تقسیم میشود. این موضوع دو پیامد عملی دارد:
- هزینه: بسیاری از سرویسها بر اساس تعداد توکن هزینه میگیرند؛ متن فارسی ممکن است توکن بیشتری از متن هماندازه انگلیسی مصرف کند.
- پنجره زمینه: هر مدل حداکثر تعداد مشخصی توکن را همزمان پردازش میکند؛ به این حد «پنجره زمینه» (Context Window) میگویند.
مدل زبانی چگونه آموزش میبیند؟
آموزش یک مدل زبانی معمولاً در چند مرحله انجام میشود:
| مرحله | چه اتفاقی میافتد | نتیجه |
|---|---|---|
| پیشآموزش (Pre-training) | مدل روی حجم عظیمی از متنهای عمومی پیشبینی ادامه متن را تمرین میکند | دانش عمومی و توانایی زبانی |
| تنظیم با دستور (Instruction Tuning) | مدل با نمونههای «دستور و پاسخ مطلوب» آموزش میبیند | پیروی از دستور کاربر |
| همراستاسازی با بازخورد انسانی | انسانها پاسخها را رتبهبندی میکنند و مدل بر اساس آن اصلاح میشود | پاسخهای مفیدتر و ایمنتر |
| تنظیم دقیق اختیاری (Fine-tuning) | مدل با داده یک حوزه یا کار خاص آموزش بیشتر میبیند | تخصص در یک حوزه یا قالب |
نکته مهم برای مدیران: پیشآموزش بسیار پرهزینه است و فقط شرکتها و مؤسسات بزرگ آن را انجام میدهند. سازمانها معمولاً از مدل آماده استفاده میکنند و برای سازگاری با کار خود، بهجای آموزش، از روشهایی مثل بازیابی از اسناد (RAG) یا در موارد خاص تنظیم دقیق بهره میبرند.
استنتاج: هنگام پاسخدادن چه اتفاقی میافتد؟
وقتی کاربر پرسشی میپرسد، مدل در مرحله استنتاج (Inference) قرار دارد. در این مرحله مدل چیز جدیدی یاد نمیگیرد؛ فقط از آنچه در آموزش آموخته استفاده میکند. ورودی مدل شامل این موارد است:
- دستور سامانه: قواعدی که سازنده برنامه برای مدل تعیین کرده؛ مثلاً «فقط بر اساس اسناد دادهشده پاسخ بده».
- سابقه گفتوگو: پیامهای قبلی همان گفتوگو.
- زمینه افزوده: اسناد یا دادههایی که برنامه برای پاسخگویی پیدا کرده و به مدل داده است.
- پرسش کاربر.
یک تنظیم مهم در این مرحله دما (Temperature) است: دمای پایین پاسخها را یکنواختتر و قابل پیشبینیتر میکند و دمای بالا خلاقانهتر اما کمتر دقیق. در کاربردهای سازمانی که دقت مهم است، معمولاً دمای پایین ترجیح دارد.
مدل از گفتوگوی شما یاد نمیگیرد
یک سوءتفاهم رایج این است که مدل با هر گفتوگو «باهوشتر» میشود یا اطلاعات شما را به خاطر میسپارد. در حالت عادی، مدل در استنتاج تغییر نمیکند. اما ارائهدهنده سرویس ممکن است گفتوگوها را ذخیره کند و طبق سیاست خود برای بهبود مدلهای آینده استفاده کند. به همین دلیل وارد کردن اطلاعات محرمانه در سرویسهای عمومی ریسک دارد؛ این موضوع را در مقاله ریسک استفاده کارکنان از ChatGPT بررسی کردهایم.
محدودیتهای مدلهای زبانی
مدلهای زبانی توانمندند، اما محدودیتهایی دارند که هر کاربر سازمانی باید بداند:
۱. توهم (Hallucination)
مدل برای تولید محتملترین ادامه متن طراحی شده، نه برای بیان حقیقت. اگر پاسخ را نداند، ممکن است پاسخی روان و باورپذیر اما نادرست بسازد: یک بند قانونی ناموجود، یک عدد ساختگی یا منبعی که وجود ندارد.
۲. تاریخ قطع دانش
دانش مدل به دادههای آموزشی تا تاریخ مشخصی محدود است. از رویدادها، قیمتها و قوانین پس از آن تاریخ خبر ندارد، مگر اینکه برنامه اطلاعات تازه را به آن بدهد.
۳. ناآگاهی از داده سازمان
مدل عمومی نامهها، قراردادها، آییننامهها و وضعیت پروژههای سازمان شما را نمیشناسد. هر پاسخی درباره این موارد بدون دسترسی به داده واقعی، حدس است.
۴. حساسیت به نحوه پرسیدن
پاسخ مدل به جملهبندی پرسش حساس است. پرسش مبهم پاسخ کلی میگیرد و پرسش دقیق پاسخ بهتری. راهنمای عملی آن را در مقاله پرامپتنویسی برای کارکنان اداری آوردهایم.
۵. سوگیری
مدل الگوهای داده آموزشی را بازتولید میکند، از جمله سوگیریها و کلیشهها.
۶. هزینه و سختافزار
اجرای مدلهای بزرگ به پردازندههای گرافیکی قدرتمند نیاز دارد و هزینه اجرا با حجم استفاده افزایش مییابد.
چرا پاسخ مدل باید به داده سازمان متکی باشد؟
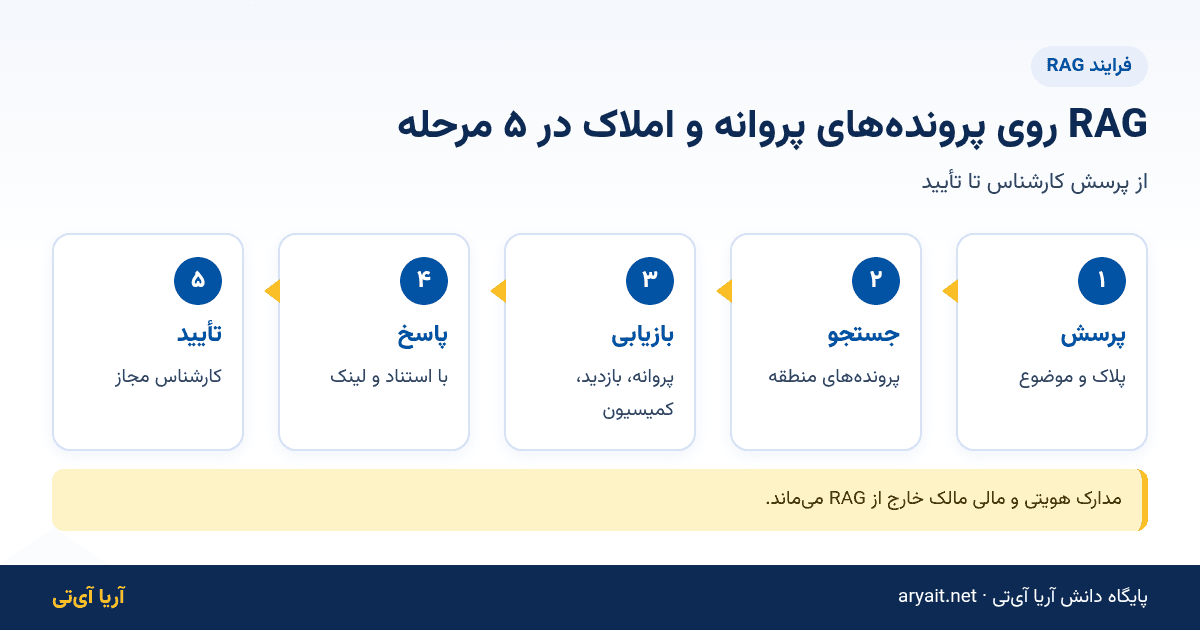
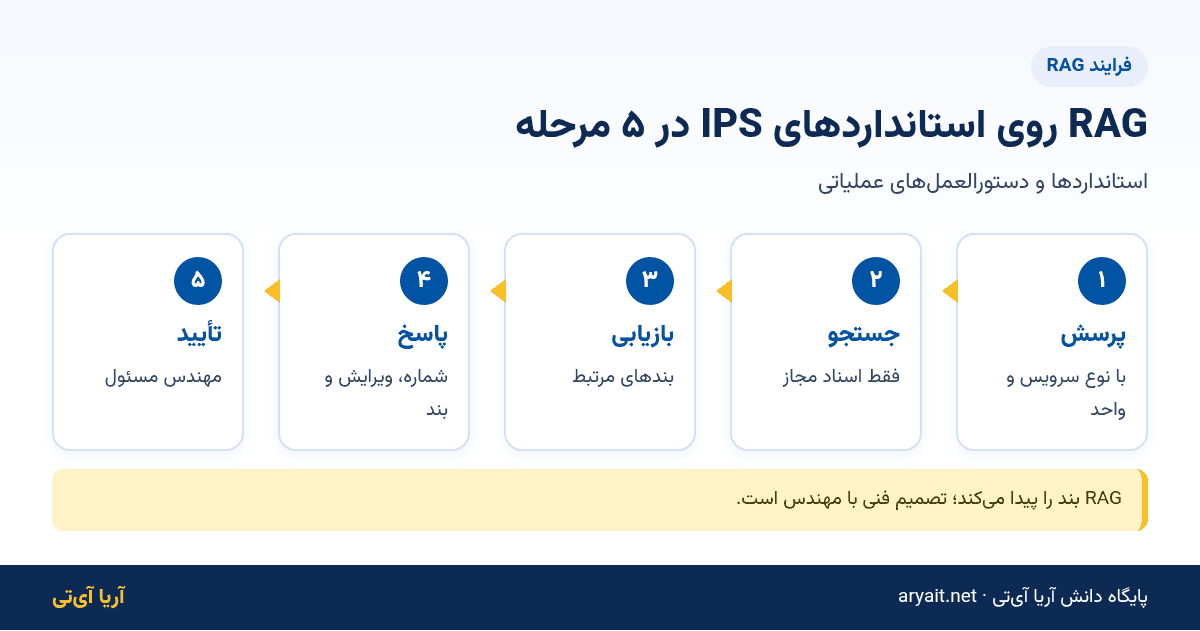
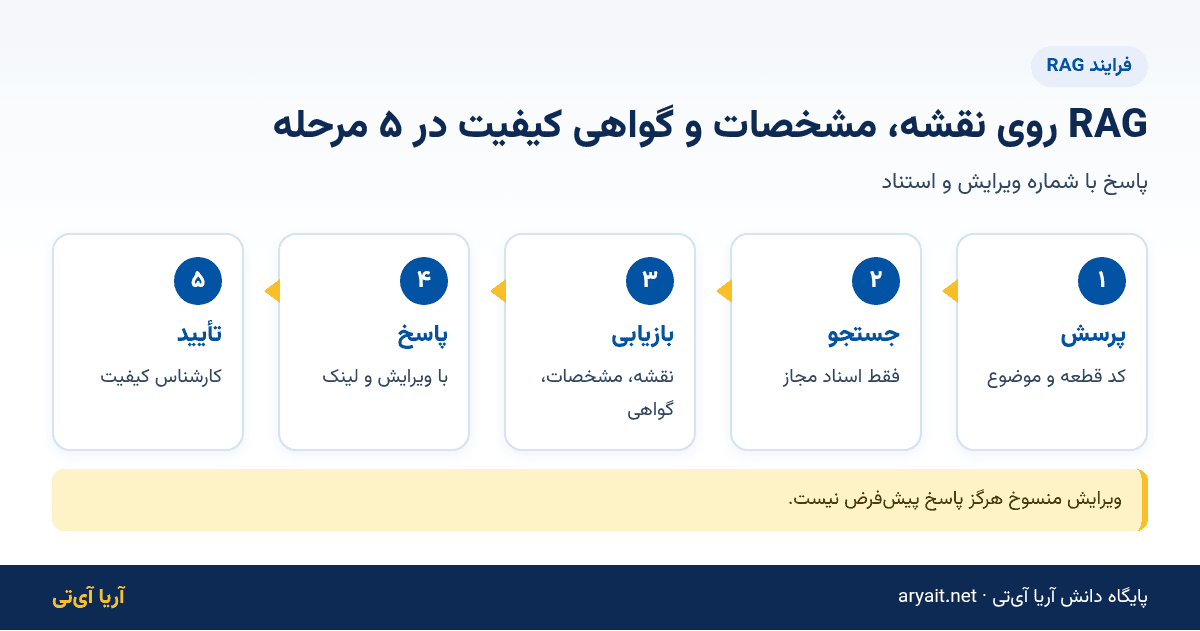
با در نظر گرفتن این محدودیتها، الگوی رایج برای استفاده سازمانی از مدلهای زبانی این است که مدل از حافظه خود پاسخ ندهد، بلکه برنامه ابتدا اسناد مرتبط را از داده مجاز سازمان پیدا کند و مدل پاسخ را بر پایه همان اسناد بسازد و به آنها ارجاع دهد. این روش (RAG) سه مزیت دارد:
- کاهش توهم: مدل به متن واقعی دسترسی دارد و میتوان از آن خواست اگر پاسخ در اسناد نیست، صریح بگوید.
- بهروز بودن: با بهروزکردن اسناد، پاسخها بهروز میشوند؛ نیازی به آموزش دوباره مدل نیست.
- قابلیت بررسی: کاربر میتواند منبع را باز کند و پاسخ را تأیید کند.
مدل زبانی، چتبات، دستیار و ایجنت
مدل زبانی موتور است، نه محصول. همین موتور در محصولات مختلف به کار میرود:
| محصول | نقش مدل زبانی |
|---|---|
| چتبات | فهم پرسش و ساخت پاسخ |
| دستیار سازمانی | پاسخ ترکیبی از داده مجاز کاربر با ارجاع |
| جستجوی معنایی | فهم معنای پرسش برای یافتن سند |
| ایجنت | استدلال و تصمیم درباره گام بعدی |
برای آشنایی بیشتر، مقالههای چتبات هوش مصنوعی چیست و ایجنت هوش مصنوعی چیست را ببینید.
چند باور نادرست رایج
- «مدل همهچیز را میداند.» مدل فقط الگوهای داده آموزشی را میشناسد و از داده داخلی سازمان و رویدادهای پس از تاریخ قطع دانش بیخبر است.
- «اگر روان و مطمئن پاسخ داد، درست است.» روانی متن نشانه درستی نیست؛ پاسخهای ساختگی هم معمولاً رواناند.
- «مدل بزرگتر همیشه بهتر است.» برای کارهای محدود مثل دستهبندی یا استخراج فیلد، مدل کوچکتر ممکن است کافی، سریعتر و ارزانتر باشد.
- «مدل جای کارشناس را میگیرد.» مدل در خواندن، خلاصهکردن و پیشنویس سریع است، اما مسئولیت تصمیم و امضا با انسان میماند.
- «هوش مصنوعی یعنی ChatGPT.» ChatGPT یکی از محصولات مبتنی بر مدل زبانی است؛ مدلهای متعدد تجاری، متنباز و ایرانی وجود دارند که برخی را میتوان روی سرور خود سازمان اجرا کرد.
چکلیست استفاده مسئولانه از مدل زبانی در سازمان
- [ ] داده محرمانه را فقط در ابزار تأییدشده سازمان وارد کنید.
- [ ] پاسخهای مهم را با منبع اصلی بررسی کنید.
- [ ] برای کارهای دقیق از ابزاری استفاده کنید که پاسخ را به سند ارجاع میدهد.
- [ ] خروجی مدل را پیشنهاد بدانید، نه تصمیم.
- [ ] بدانید داده شما کجا پردازش و نگهداری میشود.
رویکرد آریا آیتی
دستیار و جستجوی هوشمند آریا آیتی بر همین اصل ساخته شده است: پاسخ فقط از نامهها، جلسات، وظایف و اسناد مجاز همان سازمان میآید، با ارجاع به منبع و رعایت نقش کاربر. پردازش روی سرور سازمان یا سرورهای آریا آیتی انجام میشود و داده سازمان به مدلهای عمومی اینترنت فرستاده نمیشود. مدل پیشنهاد میدهد و تصمیم با انسان است.
جمعبندی
مدل زبانی بزرگ مدلی است که با پیشبینی ادامه متن، زبان را تولید و درک میکند. در چند مرحله آموزش میبیند، هنگام پاسخ چیز تازهای یاد نمیگیرد و محدودیتهایی مانند توهم، تاریخ قطع دانش و ناآگاهی از داده سازمان دارد. برای استفاده سازمانی، بهترین الگو این است که پاسخ مدل به اسناد معتبر و مجاز سازمان متکی باشد، با ارجاع به منبع و تأیید انسان.
مشاوره رایگان: برای آشنایی با نحوه استفاده امن از مدل زبانی روی داده سازمانتان، با کارشناسان آریا آیتی تماس بگیرید یا درخواست پایلوت دستیار (در پلن سازمانی) را ثبت کنید.
پرسشهای متداول
آیا مدل زبانی از گفتوگوهای من یاد میگیرد؟
+
در حالت عادی، مدل هنگام پاسخدادن تغییر نمیکند. اما ارائهدهنده سرویس ممکن است گفتوگوها را ذخیره و طبق سیاست خود برای بهبود مدلهای آینده استفاده کند؛ به همین دلیل اطلاعات محرمانه را در سرویس عمومی وارد نکنید.
چرا مدل زبانی گاهی اطلاعات نادرست میدهد؟
+
مدل برای تولید محتملترین ادامه متن طراحی شده، نه بیان حقیقت. اگر پاسخ را نداند، ممکن است پاسخی روان اما ساختگی بسازد که به آن توهم میگویند. اتکا به اسناد معتبر و ارجاع به منبع این خطر را کاهش میدهد.
توکن چیست؟
+
واحدی که مدل متن را به آن تقسیم میکند؛ ممکن است یک واژه، بخشی از واژه یا یک نشانه باشد. هزینه بسیاری از سرویسها و حد پنجره زمینه بر اساس تعداد توکن است.
آیا سازمان باید مدل اختصاصی خودش را آموزش دهد؟
+
معمولاً خیر. پیشآموزش بسیار پرهزینه است. سازمانها اغلب از مدل آماده استفاده میکنند و با بازیابی از اسناد خود (RAG) پاسخها را به داده سازمان متکی میکنند.